Vous cherchez une page précise sur un site web, mais impossible de la retrouver. Le menu principal ne suffit pas, la barre de recherche renvoie des résultats flous. Ce type de situation illustre exactement le rôle que remplit un plan du site. Loin d’être une simple formalité technique, cette page structure l’accès à l’ensemble du contenu et facilite la navigation pour les visiteurs comme pour les moteurs de recherche.
Plan du site et crawl budget : ce que les moteurs de recherche exploitent vraiment
La plupart des articles sur le sujet présentent le plan de site XML comme un accélérateur d’indexation. La réalité est plus nuancée. Google précise qu’un sitemap XML aide à découvrir des URL, sans garantir leur exploration ni leur indexation. Une page bloquée par le fichier robots.txt ou marquée en noindex ne sera pas indexée, même si elle figure dans le sitemap.
Autre point souvent ignoré : les champs priority et changefreq sont ignorés par Google. La seule balise réellement exploitée est lastmod, à condition qu’elle reflète une modification significative du contenu. Attribuer manuellement des niveaux de priorité ou des fréquences de mise à jour n’a donc plus d’effet concret.
Un sitemap XML ne compense pas non plus une mauvaise architecture de liens internes. Si vos pages profondes ne sont accessibles qu’après cinq clics, le plan XML signale leur existence aux robots, mais il ne corrige pas le problème structurel. C’est en consultant le plan du site Codyx qu’on mesure bien comment une arborescence claire rend chaque page accessible dès le premier niveau.
Plan de site HTML et accessibilité : plusieurs chemins vers la même page
Vous avez déjà remarqué que certains sites proposent à la fois un menu principal, un fil d’Ariane, une recherche interne et un plan du site ? Ce n’est pas un excès de zèle. Les recommandations WCAG 2.2 demandent que l’utilisateur dispose de plusieurs moyens pour localiser une page, sauf lorsqu’il s’agit d’une étape dans un processus séquentiel.
Le plan de site HTML répond à ce besoin de manière directe. Il affiche toutes les rubriques et sous-rubriques sur une seule page, avec des liens cliquables. Pour un visiteur qui utilise un lecteur d’écran, c’est un gain de temps considérable : au lieu de parcourir chaque menu déroulant, il accède à une vue complète de l’arborescence en un seul endroit.
Pour les personnes qui naviguent au clavier, le bénéfice est similaire. Tabuler à travers des dizaines d’éléments interactifs pour atteindre une section enfouie dans le pied de page devient inutile quand le plan du site propose un lien direct.
Trois profils qui utilisent le plan HTML au quotidien
- Les utilisateurs de lecteurs d’écran, qui accèdent à la structure complète du site sans explorer chaque rubrique séparément
- Les visiteurs réguliers qui cherchent une page dont ils ne retrouvent plus le chemin dans le menu principal
- Les navigateurs au clavier, qui évitent de tabuler à travers l’ensemble des éléments de navigation pour atteindre leur destination
Différence entre sitemap XML et plan de site HTML : deux fichiers, deux publics
Confondre ces deux formats est fréquent, mais leurs fonctions divergent complètement.
Le sitemap XML s’adresse exclusivement aux robots d’exploration. Il contient une liste d’URL avec des métadonnées techniques (date de dernière modification, notamment). Les visiteurs humains ne le consultent jamais directement.
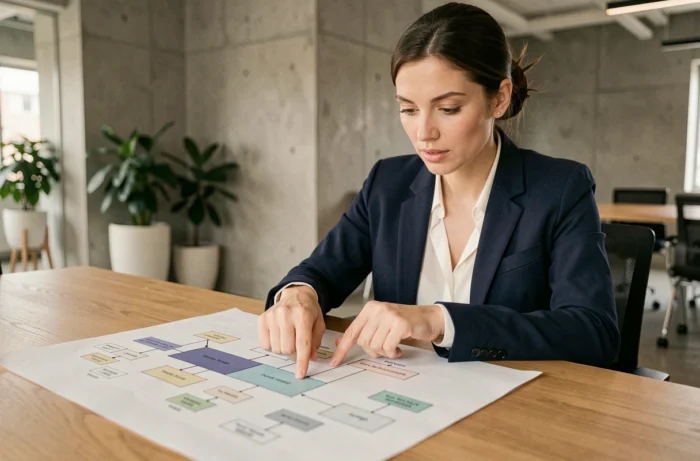
Le plan de site HTML, lui, est une page web classique destinée aux visiteurs. Il présente les liens de manière hiérarchique, souvent en reproduisant l’arborescence du site. C’est un outil de navigation, pas un fichier technique.
Quand l’un ne remplace pas l’autre
Un site qui ne dispose que d’un sitemap XML prive ses visiteurs d’un outil de repérage. À l’inverse, un site qui ne propose qu’un plan HTML perd un canal de communication avec les moteurs de recherche. Les deux formats se complètent sans se substituer l’un à l’autre.
Côté technique, la méthode de notification a changé. L’ancien endpoint de ping des sitemaps chez Google a été abandonné en 2023. Les méthodes valides aujourd’hui sont la déclaration du sitemap dans le fichier robots.txt et l’envoi via la Search Console.
Construire un plan du site utile : les erreurs concrètes à éviter
Un plan de site mal conçu peut devenir contre-productif. Voici les pièges les plus courants.
- Lister des URL obsolètes ou redirigées, ce qui envoie des signaux contradictoires aux robots et désoriente les visiteurs
- Générer automatiquement le plan sans vérifier la cohérence avec la navigation réelle du site (pages orphelines, rubriques vides)
- Inclure des pages que vous ne souhaitez pas indexer (pages de connexion, résultats de filtres, doublons paginés)
- Utiliser des dates lastmod fictives pour simuler une fraîcheur de contenu, ce qui dégrade la confiance des moteurs envers votre sitemap
Un plan de site efficace reflète fidèlement la structure réelle du site. Chaque URL listée doit être accessible, indexable et pertinente. Les pages dynamiques comme les archives de blog méritent d’y figurer, à condition qu’elles apportent un contenu distinct.
Pour le plan HTML, la lisibilité prime. Regrouper les liens par rubrique, limiter la profondeur visible à deux ou trois niveaux, et nommer chaque lien de manière explicite suffit à rendre la page utile. Un plan du site qui liste des centaines de liens sans hiérarchie visible perd tout intérêt pour le visiteur.
Le plan du site reste un des rares éléments qui sert simultanément le référencement naturel, l’accessibilité et l’expérience de navigation. Sa mise en place demande peu de temps comparé au bénéfice structurel qu’il apporte, à condition de maintenir sa cohérence avec l’architecture réelle du site à chaque mise à jour.